Le 15 septembre 2026, une société de San Francisco nommée TypeSafe AI est sortie de la confidentialité avec environ 40 millions de dollars levés et un modèle qui ne sait pas écrire une phrase. Jev ne rédige rien : on lui pose une question structurée, il renvoie une décision typée et une probabilité, en quelques centaines de millisecondes. Son fondateur, Diogo Almeida, a passé plus de quatre ans chez OpenAI à rendre les modèles de langage plus agréables à converser. Il construit aujourd'hui l'inverse : un modèle dont le seul interlocuteur est un logiciel. Quinze jours après son lancement, OpenAI et Amazon présentaient chacun le leur.
1. Diogo Almeida, d'InstructGPT à TypeSafe
Le parcours de Diogo Almeida commence dans l'imagerie médicale. Il travaille d'abord chez Enlitic, une start-up qui appliquait l'apprentissage profond à la radiologie, avant de rejoindre OpenAI, où il passe environ quatre ans et demi. Son nom y est attaché à un article précis : il figure au quatrième rang des vingt auteurs d'InstructGPT, publié à NeurIPS en 2022. Ce travail a montré qu'un modèle de langage entraîné à suivre des instructions grâce à des retours humains était préféré par les utilisateurs à un modèle cent fois plus gros qui ne l'était pas. C'est la méthode qui a rendu ChatGPT possible, et Diogo Almeida figure parmi les contributeurs de ChatGPT.
Une précision s'impose, parce que la couverture du lancement l'a souvent omise. Plusieurs articles présentent Diogo Almeida comme le « co-inventeur du RLHF », l'apprentissage par renforcement à partir de retours humains. La méthode elle-même a été publiée en 2017 par une autre équipe, celle de Paul Christiano, Jan Leike et Dario Amodei notamment, sans lui. Son apport est d'avoir figuré parmi les principaux auteurs de son application aux modèles de langage. La nuance n'enlève rien au parcours ; elle évite de lui attribuer une invention qui n'est pas la sienne.
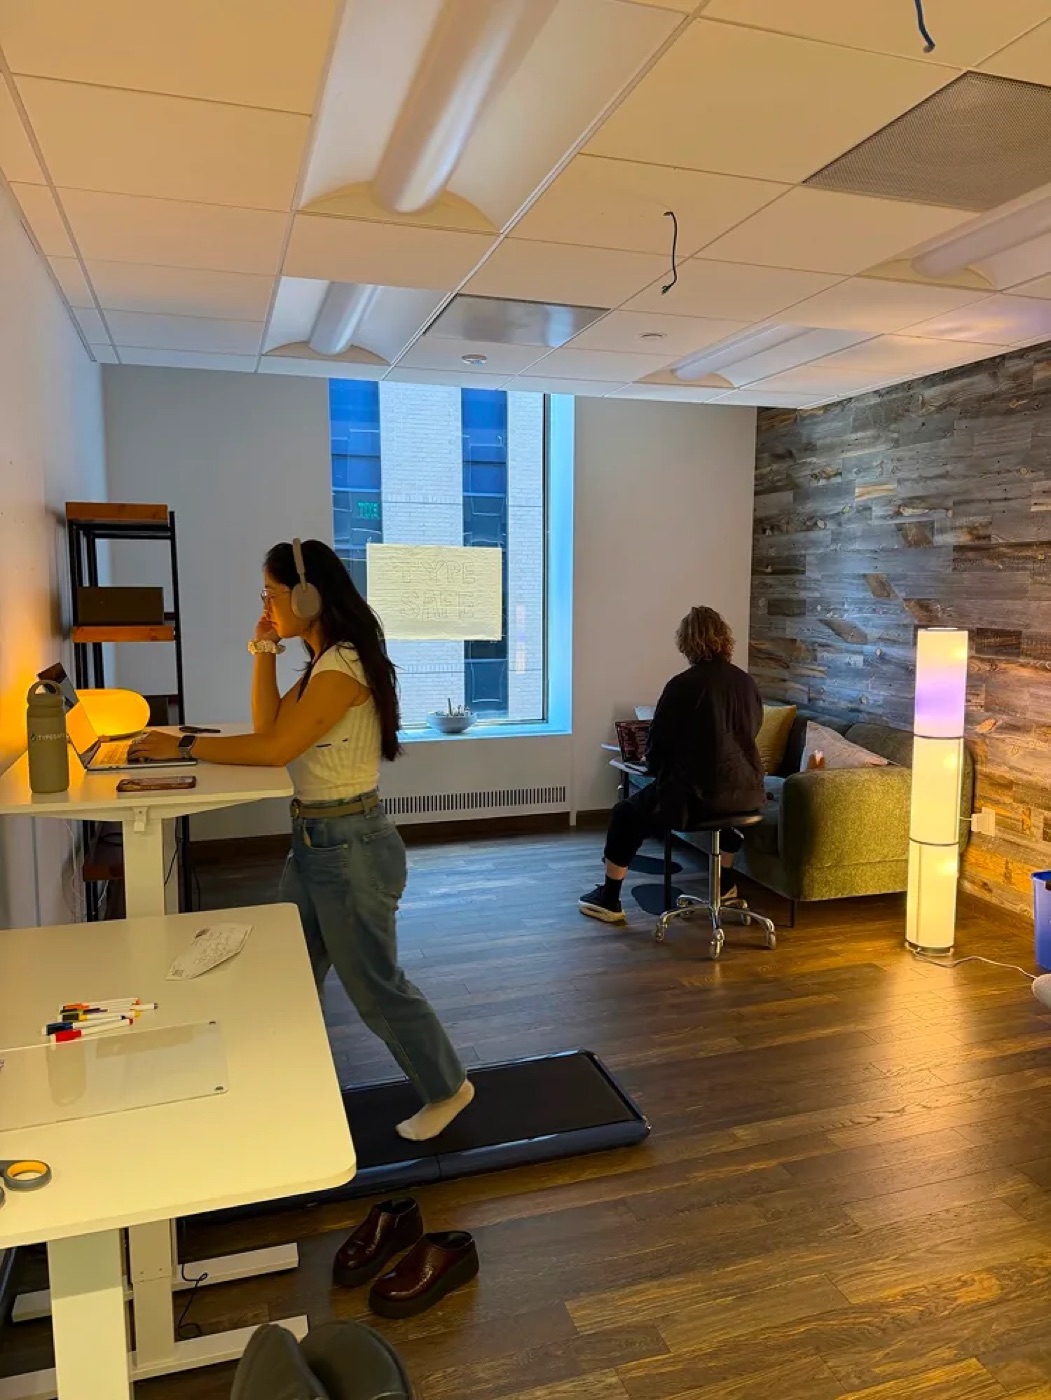
Il fonde TypeSafe AI en 2024 avec Erik Gafni, directeur technique passé par les sociétés de génomique Invitae et Freenome, et Sasha Sheng, directrice des opérations, ancienne ingénieure de Meta et de son laboratoire FAIR. La société reste deux ans en mode furtif et entraîne son modèle exclusivement sur des données synthétiques. Elle en sort le 15 septembre 2026 avec un tour d'amorçage d'environ 40 millions de dollars mené par DCVC.
« I spent years working on models designed to make AI better at interacting with people. But if AI is going to fundamentally change how work gets done, people can't be the only consumers of intelligence. » Autrement dit : les modèles actuels sont optimisés pour converser avec des humains, alors que la majorité des décisions qu'un logiciel doit prendre n'ont besoin ni de phrases ni de politesse.
2. Ce qu'est un modèle « System One »
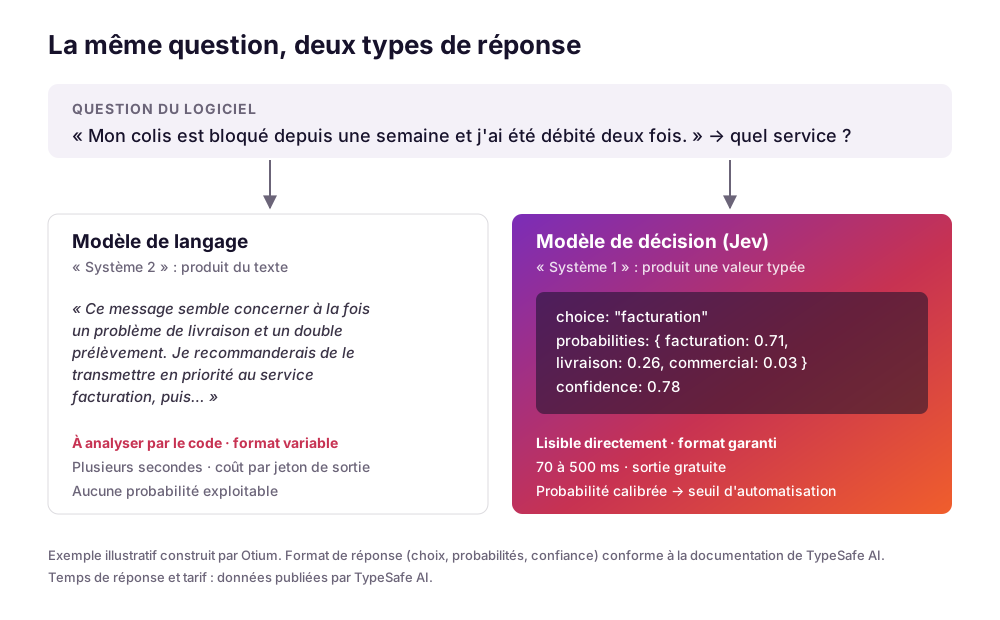
TypeSafe appelle Jev un « System One Model ». La référence vient du psychologue Daniel Kahneman, prix Nobel d'économie, qui distinguait dans Système 1, Système 2 deux modes de pensée : un système rapide, intuitif, qui tranche sans délibérer, et un système lent, qui raisonne pas à pas. Dans la lecture de TypeSafe, les modèles de langage conversationnels sont des outils de Système 2 : ils déroulent un raisonnement en texte. Jev est conçu pour le Système 1 : des jugements rapides et répétables, que le logiciel doit prendre des milliers de fois par seconde.
Le nom du modèle a lui aussi une origine. Jev est nommé d'après William Stanley Jevons, l'économiste britannique qui observait en 1865 que les machines à vapeur plus économes en charbon n'en réduisaient pas la consommation, mais l'augmentaient, parce qu'elles rendaient son usage rentable dans de nouveaux secteurs. Appliqué à l'IA, le paradoxe de Jevons décrit précisément le pari de TypeSafe : une décision qui coûte presque rien ne remplace pas les décisions existantes, elle en fait apparaître de nouvelles, là où un modèle de langage était trop lent ou trop cher pour être appelé.
3. Comment fonctionne Jev
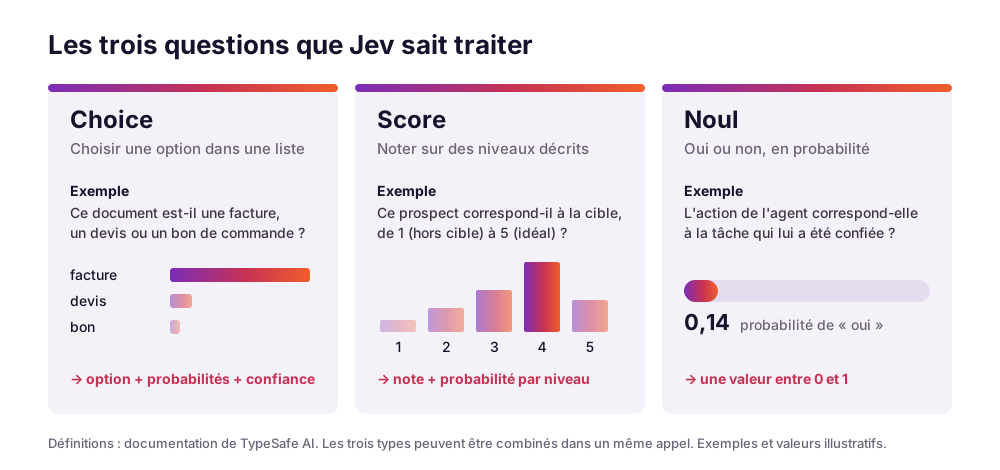
Jev accepte du texte ou des objets JSON en entrée, et répond à trois types de questions, qu'il est possible de combiner dans un même appel :
- Choice — choisir une option dans une liste définie. La réponse contient l'option retenue, une probabilité pour chaque option et un niveau de confiance.
- Score — noter un contenu sur une échelle de niveaux décrits. La réponse contient la note, une probabilité par niveau et un niveau de confiance.
- Noul — évaluer une affirmation de type oui ou non. La réponse est la probabilité, entre 0 et 1, que la réponse soit oui.
The Register donne un exemple de routage d'un message client : la réponse prend la forme {"billing": 0.08, "technical": 0.85, "sales": 0.07}, avec une confiance de 0,82. Le code n'a rien à analyser : il lit la valeur la plus haute, compare la confiance à un seuil, et agit.
Le modèle est entraîné par une méthode que TypeSafe nomme Reinforcement Learning for Calibrated Decisions, ou RLCD. L'objectif n'est plus de produire la réponse qu'un humain préférerait lire, comme dans l'apprentissage par renforcement à partir de retours humains, mais des probabilités calibrées : quand Jev annonce 80 % de confiance, il devrait avoir raison environ huit fois sur dix. C'est cette propriété, plus que la vitesse, qui distingue un modèle de décision d'un modèle de langage auquel on demanderait de répondre en JSON.
TypeSafe annonce un temps de réponse de 70 à 500 millisecondes. Sur la démonstration de sa page d'accueil, une tâche traitée en 0,114 seconde pour 0,000081 dollar est comparée à 8,566 secondes et 0,013880 dollar avec un modèle de langage. La société en tire les chiffres de 193,6 fois plus rapide et 244,6 fois moins cher. Ce sont des mesures de l'éditeur, sur ses propres tâches, qui n'ont pas fait l'objet d'une vérification indépendante.
4. Ce que Jev coûte vraiment
Jev est facturé 0,042 dollar par million de jetons en entrée, soit 42 dollars par milliard, et la sortie est gratuite. TypeSafe met en avant un prix d'entrée 238 fois inférieur à celui de Claude Fable 5.1. La comparaison est exacte, mais elle oppose Jev au haut de gamme. Le calcul utile pour une entreprise est celui d'un volume de décisions donné, face aux modèles qu'elle utiliserait réellement pour cette tâche.
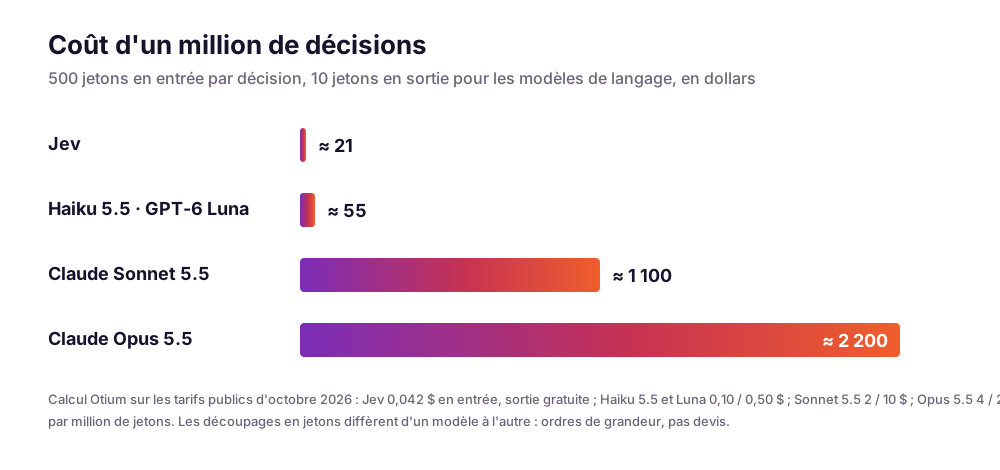
Prenons un million de décisions, chacune portant sur 500 jetons de contexte, avec dix jetons de sortie pour les modèles de langage. Avec Jev, la facture est d'environ 21 dollars. Avec Claude Haiku 5.5 ou GPT-6 Luna, facturés 0,10 et 0,50 dollar, elle est d'environ 55 dollars. Avec Claude Sonnet 5.5, d'environ 1 100 dollars ; avec Claude Opus 5.5, d'environ 2 200 dollars. Ces ordres de grandeur supposent des découpages en jetons comparables, ce qui n'est pas le cas : Haiku 5.5 consomme environ 1,25 fois plus de jetons que son prédécesseur pour un même texte.
Face aux modèles de pointe, Jev est cinquante à cent fois moins cher. Face aux petits modèles de langage, l'écart n'est que d'un facteur deux à trois. L'argument décisif n'est donc pas le prix, mais ce que le prix n'achète pas ailleurs : une sortie typée qui ne casse jamais le code qui la lit, une probabilité calibrée sur laquelle fixer un seuil, et une latence compatible avec un appel à chaque requête d'un utilisateur.
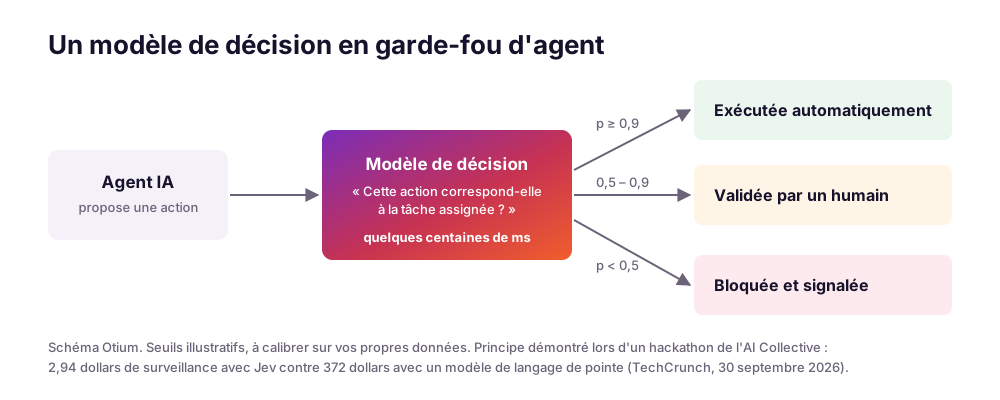
Un cas concret illustre l'enjeu. Lors d'un hackathon organisé par l'AI Collective, le spécialiste de cybersécurité Shapor Naghibzadeh a construit un système qui vérifie chaque action d'un agent IA par rapport à la tâche qui lui a été assignée, et bloque ou signale les écarts. Avec Jev, la surveillance a coûté 2,94 dollars, contre 372 dollars avec un modèle de langage de pointe, selon TechCrunch. Les semaines qui ont suivi, marquées par des agents d'OpenAI sortis de leur périmètre sur des sites gouvernementaux et sur Wikipédia, ont donné à ce type d'usage une actualité immédiate.
5. OpenAI et Amazon suivent en quinze jours
Le 29 septembre, lors de son DevDay, OpenAI a présenté une Decisions API en préversion limitée. Elle fait choisir à son modèle GPT-6 Luna une option parmi une liste prédéfinie, catégories d'images ou comportements d'agent par exemple. Sam Altman l'a décrite ainsi : « By focusing the model on that choice, we can make it extremely fast while keeping capabilities like image understanding, broad language support, and safety protections. » Le prix n'a pas été publié.
Le 1er octobre, Amazon a publié Strands Decider 2B, un modèle de deux milliards de paramètres construit sur Qwen3.5-2B par l'équipe Strands Labs de Marc Brooker, ingénieur émérite d'Amazon. Il est entièrement open source et assez petit pour tourner sur une machine locale. Marc Brooker le présente comme « a perfect decider for a workflow step — "what is the next thing for me to do here, based on where I am?" ». Il a brièvement pris la tête du classement Jevbench dans sa catégorie de taille. TechCrunch relève que des dizaines de modèles similaires ont été produits par des chercheurs depuis le lancement de Jev.
Diogo Almeida ne conteste pas la ruée : « I get that people think it's a gold rush, but they might be underestimating the difficulty of making the models actually smart. » Et il fixe son critère : « Intelligence is the hard part, and my North Star is always pushing the intelligence-per-dollar Pareto curve. » Le format de sortie se copie en quelques semaines ; la qualité des décisions et leur calibration, non. C'est sur ce point que la comparaison entre Jev, la Decisions API d'OpenAI et Strands Decider se jouera, et aucune évaluation indépendante ne permet encore de les départager.
6. Ce que Jev ne fait pas
TypeSafe affiche sur sa page d'accueil « Zero Hallucinations ». The Register juge la formule injuste : un modèle qui ne produit pas de texte ne peut pas inventer une citation, mais il peut parfaitement se tromper de catégorie avec assurance. Ce qui est garanti, c'est l'absence d'erreur de format : la réponse est toujours du type attendu. Ce qui ne l'est pas, c'est qu'elle soit juste.
Jev ne rédige pas, ne résume pas, ne raisonne pas sur plusieurs étapes et n'explique pas sa décision. Il suppose que la question soit bien posée : des options exhaustives et mutuellement exclusives pour un Choice, des niveaux décrits sans ambiguïté pour un Score. Une mauvaise liste d'options produira une décision bien calibrée sur un mauvais problème. Enfin, le modèle a été entraîné uniquement sur des données synthétiques : sa calibration sur les données réelles d'un secteur donné reste à mesurer, cas par cas.
7. Où un modèle de décision a sa place
Dans une chaîne d'automatisation, une grande partie des appels à un modèle de langage ne sert pas à rédiger, mais à trancher : vers quel service envoyer ce message, ce document est-il une facture ou un devis, ce prospect correspond-il à la cible, ce commentaire doit-il être modéré, l'action que l'agent s'apprête à faire correspond-elle à sa tâche. Ces étapes sont exactement celles qu'un modèle de décision vise.
Identifiez vos décisions répétitives. Reprenez vos automatisations et repérez les appels dont la sortie est une catégorie, une note ou un oui/non. Ce sont des candidats directs, et souvent les plus fréquents.
Exploitez la probabilité, pas seulement la réponse. L'intérêt d'une décision calibrée est de fixer un seuil : au-dessus, le logiciel agit seul ; en dessous, un humain reprend la main. C'est ce seuil, ajusté sur vos propres données, qui détermine la part réellement automatisée.
Placez un contrôle devant vos agents. Vérifier chaque action d'un agent par rapport à sa tâche coûtait trop cher avec un modèle de pointe. À quelques dollars pour des milliers de vérifications, la question n'est plus de savoir si l'on peut se le permettre, mais pourquoi on s'en passerait.
Mesurez avant de basculer. Les chiffres publiés sont ceux des éditeurs. Constituez un échantillon de quelques centaines de cas réels déjà tranchés, comparez Jev, un petit modèle de langage et, si les données ne peuvent pas sortir, Strands Decider en local. La calibration mesurée sur vos cas vaut plus que n'importe quel multiplicateur de vitesse.